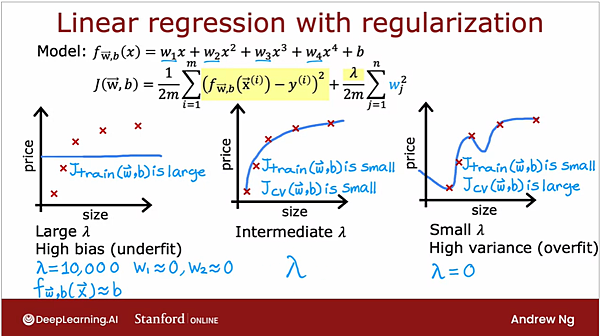
之前曾經介紹過的 regularization ,主要作用也是在調整 bias 和 variance 之間的尺度,
regularization 是被加在 cost function裡面,作為一個「懲罰」,如果數字越大,cost 就會越高,
如果建出來的model 內含的高次方項越多,就會造成懲罰項的增加,因此演算法會傾向於找一個不含高次方項的方向。
用來調整懲罰力度的就是分子上的lambda 項,如果數字太大,懲罰的力度太大就會導致最左邊的結果,
最左邊的model 被過度簡化了,導致它的model 只剩下一個常數項,這就是「欠擬合」,也就是 high bias,
William.Echoes 發表在
痞客邦
留言(0)
人氣()
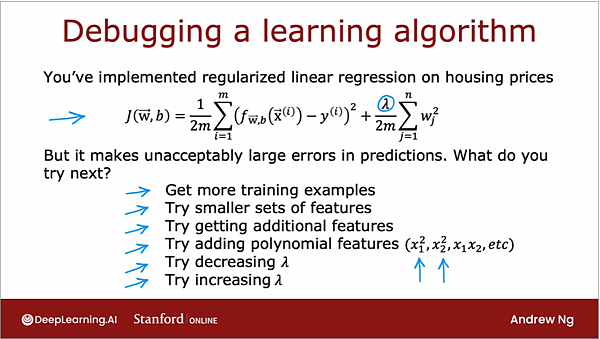
第三週主要是談論一些實務上如何把機器學習給應用得更好的手法。
假設今天在一個線性廻歸問題上,我們的機器學習演算法在做預測時誤差很大,那我們該做些什麼呢?
第一,有可能是資料數不夠,因此收集更多資料會是手法之一。
第二,特徵 (feature) 有問題,可能是來自於數量太多/太少,或是需要做一些處理來加入多次項
第三,演算法的參數有問題,比方說,regularization 的參數設得太大或太小。
William.Echoes 發表在
痞客邦
留言(0)
人氣()

本週的最後,介紹多元分類所需要使用的演算法。
先前介紹的都是二元分類,因此數字只會有0或1兩種可能性,使用 cross entropy 等演算法,
但是如果要區分的類別並不是只有2類,而是更多,就比較複雜了。
這裡要引入的新概念叫做 softmax,如下面投影片的右邊,
softmax regression 和 logistic regression 在本質上是類似的,都是要讓輸出值的加總 = 1,
William.Echoes 發表在
痞客邦
留言(0)
人氣()

Tensorflow 和 Pytroch 目前是大家在寫人工智慧時會使用的兩大方法,
他們的出現讓大家不用再辛苦地把人工智慧的數學式給逐碼coding 出來,大大降低使用的門檻。
上圖所示的就是使用 tensorflow的語法操作 forward propagation 時的呈現方法,
首先 (數字1) 定義整個類神經網路的運作架構之後,
接下來(數字2) 就是編輯一些細節, tensorflow內建有很多 loss function 讓我們可以直接打出來,
William.Echoes 發表在
痞客邦
留言(0)
人氣()

接下來開始討論怎麼樣應用時下最流行的框架之一: Tensorflow,來編寫人工智慧程式,
並且通過烘煮咖啡來舉例。
情境是我們有兩個變因來控制咖啡豆,分別是溫度與時間,X 是滋味好的,O是滋味不好的,
其實從分類的圖上,我們能大略辨識出中間的區塊,也就是溫度與時間都剛剛好的條件,會有滋味好的咖啡,
而要怎麼寫人工智慧程式讓AI學會這件事呢?
William.Echoes 發表在
痞客邦
留言(0)
人氣()

本課程接下來介紹的是類神經網路 (NN)的運作原理,上面所示的是一個基本的NN,
有一個3個neuron 的隱藏層和一個nueron 的輸出層,
如果我們放大隱藏層來看:
如果我們要解決的是前文提到的判斷衣服是否暢銷的問題,
那我們神經元裡放的activation function 就會是 sigmoid function,
William.Echoes 發表在
痞客邦
留言(0)
人氣()

本專項課程的第二堂課為 Advanced Learning Algorithms,
前三週介紹現今最主流的一種演算法: Neural Network 類神經網路,
最後一週介紹 Decision Tree 決策樹。
講到 Neural Network,必然先解決它的起源。
雖然類神經網路是在近期才廣為世人所知,它事實上是數十年前的產物,
William.Echoes 發表在
痞客邦
留言(0)
人氣()

第三週的第一段落介紹完 logistic regression 的基本之後,就要來介紹如何優化模型,
所以要先從 loss function 的定義開始介紹。
前面提到線性迴歸最常用的cost function 就是 squared error,也就是把真實值和預測值的誤差給取平方後再取平均,
這樣的cost function 會自然而然形成可以收歛的二次方程式,當抵達 loss 不在降低的地方時就停止訓練。
不過 squared error 不適用在 logistic regression,因為 logistic regression 是用 sigmoid function的形式來表現,
William.Echoes 發表在
痞客邦
留言(0)
人氣()

前兩週談完了 linear regression,第三週進入新的主題: 分類問題 (classification)。
Regression 和 Classification 最大的差異在於,
前者是針對無限的連續數字去建模,而後者只能允許output 有兩個數字: 0或是1,
一般來說,0代表「否」(no 或是 false),而1代表「是」 (yes 或是 true),
這個做法稱之為「二元分類」(binary classification),
William.Echoes 發表在
痞客邦
留言(0)
人氣()
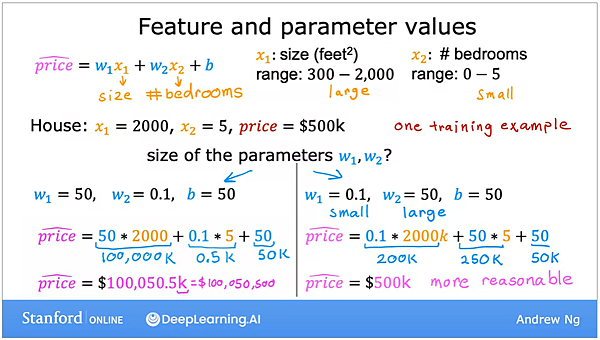
本週第二部分,開始介紹如何讓多變數線性迴歸的gradient descent 做得更順暢。
舉例來說,假設有個房價公式會考量房子的大小 (X1) 和房間的數量 (X2),
因為房子的大小通常是以數百到上千平方呎來計算,而房間的數量基本上都是個位數 (0~5),
所以兩個X的數值有數量級的差異 (三~四位數 vs 個位數),
因此一個合理的 w1和w2,當然是w1會很小,而w2會很大,才有辦法產生合理的房價預測值 (除非X1真的有很大的影響力…)。
William.Echoes 發表在
痞客邦
留言(0)
人氣()

第一週談完基本的單變數線性迴歸 (y=wx+b) 和 cost function的概念之後,
第二週把概念擴展到多變數的線性迴歸上。
真實的世界不會只有一個變因,比方說影響房價的不只會有大小,還包括有幾層樓、屋齡有多久等等,
這些變因,也就是 input,我們稱之為 feature (特徵),特徵的數量以n來表示,
既然有多個特徵,則要給他們編號 j ,編號就會放在右下角,而樣品編號 i 則放在右上角。
William.Echoes 發表在
痞客邦
留言(0)
人氣()

本週一開始我們先來快速回顧一下 Linear Regression的內容,
在優化線性迴歸模型 Y = wx+b時,我們是透過改變 w 與 b的值來尋求一個能夠儘可能解釋每一筆資料的方程式,
這個 w 跟 b 在機器學習的世界中當然是透過自動化來找到的,
每找到一個 w和b的組合,我們就要把每一筆資料的input代入方程式中,算出估計值和實際值之間的差距,
用來計算差距的方程式我們稱為 Cost Function (代價函數),代號是J,為一個w和b的函式 J(w,b)
William.Echoes 發表在
痞客邦
留言(0)
人氣()
